Uma GPU num servidor de 180 W: Upgrade do HPE MicroServer Gen10 Plus para cargas de trabalho de IA
Adicionar uma NVIDIA RTX A1000 e um Xeon de 6 núcleos a um servidor compacto, mantendo-se dentro dos 180 W da fonte com RAPL e limites de potência
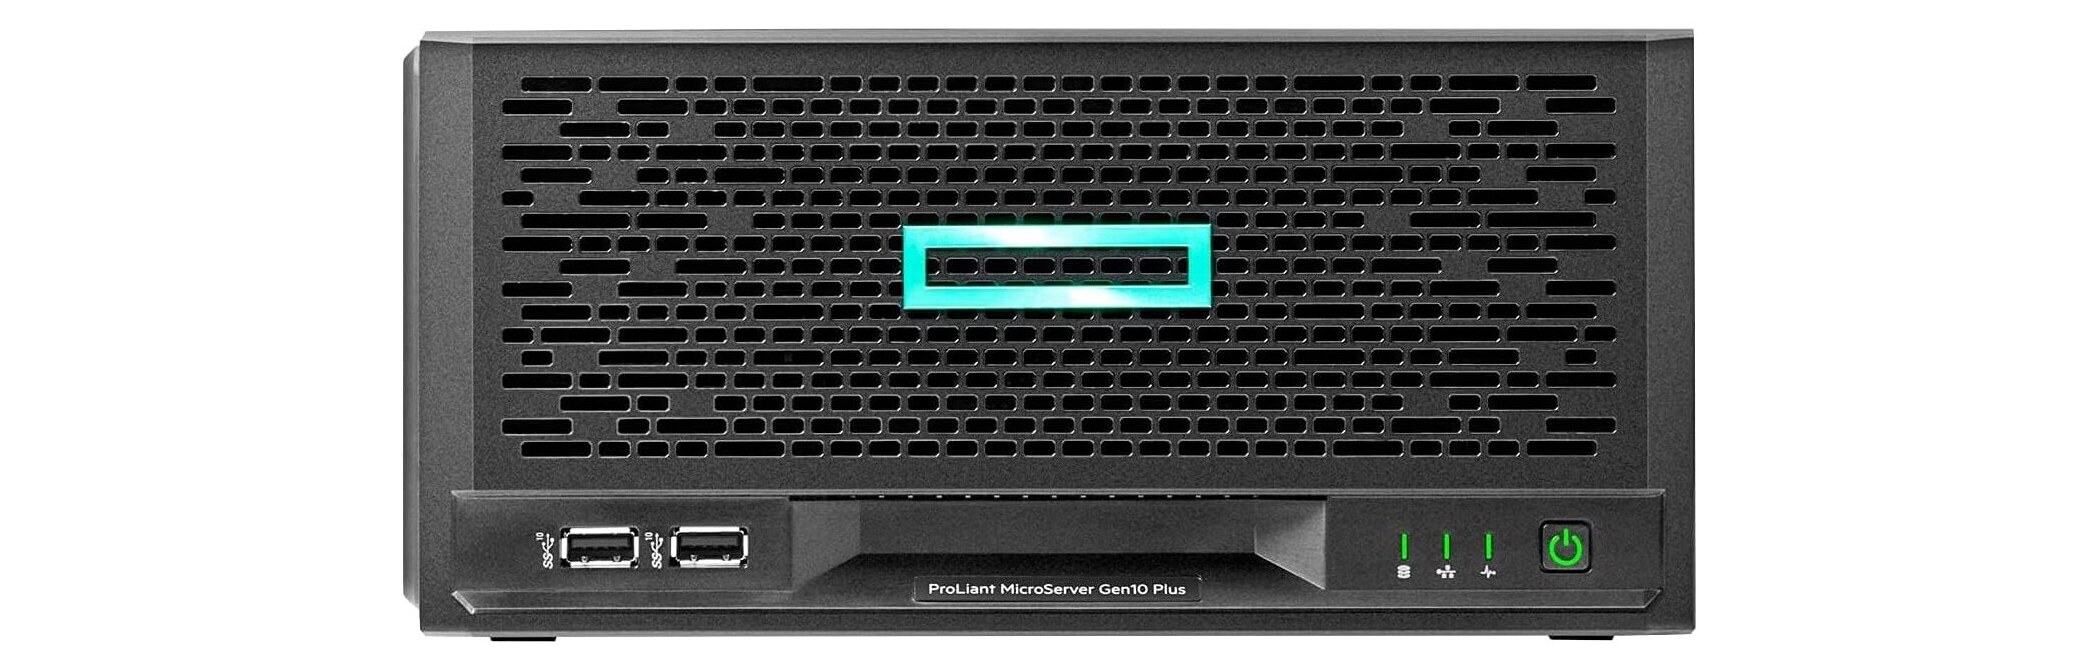
Uma placa gráfica e a troca do CPU transformaram um servidor homelab compacto e silencioso numa máquina de inferência de IA, sem substituir a carcaça nem exceder os 180 W da fonte de alimentação. A indexação de 15.000 fotografias passou de cerca de uma hora para menos de dez minutos. A geração de embeddings de um livro de 400 páginas passou de três minutos para vinte segundos. O obstáculo: encaixar uma GPU e um CPU mais rápido dentro de um balanço de consumo de 180 W exige aplicação por software, não apenas uma seleção de hardware cuidadosa.
| Carga de trabalho | Antes (só CPU) | Depois (GPU) | Aceleração |
|---|---|---|---|
| Análise da biblioteca de fotos (15 k imagens) | ~60 min | < 10 min | 6×+ |
| Embedding de livro (400 páginas) | 3–4 min | ~20 s | ~10× |
| Consumo máximo do sistema | — | ≤ 170 W | dentro dos 180 W da fonte |
| Hardware substituído | — | GPU + CPU apenas | sem novo servidor |
As acelerações de ML acima são ganhos exclusivos da GPU. O upgrade do CPU (E-2224 → E-2246G, 4 núcleos / 4 threads → 6 núcleos / 12 threads) foi motivado pela concorrência: 33 containers distribuídos por múltiplas stacks Docker já estavam a saturar a capacidade de escalonamento do CPU anterior, independentemente de qualquer carga de trabalho de IA.
O servidor
A minha máquina principal de homelab é um HPE ProLiant MicroServer Gen10 Plus. Não é um servidor vistoso. Está silenciosamente numa prateleira, consome pouca energia, faz quase nenhum ruído, e corre Proxmox VE com alguns containers Linux e VMs para os serviços que uso diariamente: Home Assistant, Nginx, um DNS local, monitorização de rede, e uma instância do Immich que gere a biblioteca de fotografias da família.
A restrição fundamental da máquina é a fonte de alimentação: um adaptador externo de 180 W (LiteOn P19429-001). Esse teto condiciona todas as decisões de hardware.
O CPU original era um Intel Xeon E-2224 — 4 núcleos, 4 threads, 71 W TDP. Adequado para a carga de trabalho de então, mas duas coisas mudaram.

Por que queria mais
Machine learning no Immich
O Immich é uma alternativa self-hosted ao Google Fotos. O que o torna genuinamente útil é o pipeline de ML: corre CLIP para pesquisa semântica de imagens (escrever “pôr do sol na praia” e encontra as fotografias da praia), reconhecimento facial para agrupar pessoas em milhares de imagens, e deteção de objetos para álbuns inteligentes.
Por defeito, o Immich pode correr estes modelos no CPU. Funciona, mas é lento. Uma GPU reduz o tempo de inferência dos modelos em uma ordem de grandeza. Com uma GPU, a análise inicial da biblioteca, que levaria horas no CPU, conclui em minutos, e a pesquisa inteligente responde em menos de um segundo em vez de vários.
Embeddings para Book RAG
Tenho também um sistema de pesquisa semântica sobre a minha biblioteca pessoal de livros, um projeto a que chamo Book RAG. Analisa EPUBs e PDFs, divide o texto em fragmentos por capítulo, e guarda cada fragmento como um vetor de 1024 dimensões no Qdrant, usando o modelo de embedding BGE-M3 servido via HuggingFace TEI (Text Embeddings Inference). Em tempo de consulta, o Claude Code usa os vetores para encontrar as passagens mais relevantes de qualquer livro da biblioteca.
No CPU, gerar os embeddings de um livro de 400 páginas demora vários minutos. Na GPU, demora segundos. A diferença é relevante ao ingerir um livro novo ou ao re-indexar a biblioteca depois de uma atualização de modelo.
Por que a RTX A1000

Já tinha experimentado uma GPU nesta máquina: uma Quadro P400. Conseguia lidar com o ML do Immich ou com o Book RAG individualmente, mas não com ambos ao mesmo tempo. A P400 tem 2 GB de VRAM. O BGE-M3 sozinho carrega cerca de 1,5 GB para VRAM; os modelos de ML do Immich acrescentam mais um gigabyte. Correr ambos em simultâneo esgotava a memória da placa e provocava erros de out-of-memory no contentor TEI.
A RTX A1000 vem com 8 GB de GDDR6. As duas cargas de trabalho cabem confortavelmente, com margem para o overhead do sistema operativo e alocações do driver. A placa é também de meia altura e single-slot, o que importa na carcaça condicionada do MicroServer, e o seu TGP de 35 W significa que não é necessário conector de alimentação auxiliar.
Mais núcleos
Para além do caso de uso da GPU, passar de um E-2224 de 4 núcleos para um processador de 6 núcleos/12 threads dá ao Proxmox consideravelmente mais margem para correr containers e VMs em simultâneo. O E-2246G que escolhi tem o mesmo socket (LGA1151) e encaixa no mesmo cooler, com 6 núcleos, 12 threads, e uma frequência base de 3,6 GHz a subir até 4,8 GHz em single-core.
O problema do consumo
Adicionar uma GPU e fazer upgrade do CPU aumentam ambos o consumo máximo. A fonte de 180 W não tem margem de manobra: é um teto rígido imposto pelo hardware.
Eis as especificações nominais de cada componente:
| Componente | TDP / TGP de origem |
|---|---|
| Intel Xeon E-2224 (antigo) | 71 W |
| Intel Xeon E-2246G (novo) | 80 W TDP |
| NVIDIA RTX A1000 | 50 W TGP |
| RAM, NICs, motherboard, ventoinhas, discos | ~40 W |
Números nominais: 80 + 50 + 40 = 170 W. À primeira vista cabe nos 180 W com 10 W de sobra. Mas o valor TDP da Intel corresponde à carga contínua; o limite de consumo em burst (PL2) é mais alto. Por defeito, o E-2246G pode atingir cerca de 140 W em rajadas curtas. Somando uma GPU sem limite e o resto do sistema, o pico pode facilmente ultrapassar os 230 W, excedendo a fonte.
A solução é limitar os dois.
Intel RAPL: limitar o CPU
O Intel Running Average Power Limit (RAPL) permite que o software aplique limites
de potência rígidos ao pacote CPU através de uma interface do kernel em
/sys/class/powercap/intel-rapl/intel-rapl:0/. Existem dois limites:
- constraint_0 (PL1): o limite de consumo em carga contínua. O CPU opera a este nível ou abaixo dele indefinidamente.
- constraint_1 (PL2): o limite de consumo em burst. O CPU pode exceder o PL1 até este valor durante uma janela curta (~2 ms por defeito).
Defini PL1 para 75 W e PL2 para 95 W. O raciocínio:
- PL1 = 75 W é 94% do TDP de 80 W, suficientemente próximo do desempenho máximo em carga contínua.
- PL2 = 95 W está abaixo do PL2 de origem do E-2224, que era de 100 W, sendo portanto um envelope de burst mais conservador do que a configuração anterior.
Estes valores são expressos em microwatts na interface do kernel: 75 W = 75000000,
95 W = 95000000.
Para tornar o limite persistente entre reinicializações e aplicado antes de qualquer carga de trabalho iniciar, criei um serviço systemd oneshot:
# /etc/systemd/system/cpu-powerlimit.service
[Unit]
Description=Set Intel RAPL CPU package power limit
DefaultDependencies=no
After=sysinit.target
Before=multi-user.target pve-guests.service
ConditionPathExists=/sys/class/powercap/intel-rapl/intel-rapl:0

[Service]
Type=oneshot
ExecStart=/bin/sh -c 'echo 75000000 > /sys/class/powercap/intel-rapl/intel-rapl:0/constraint_0_power_limit_uw'
ExecStart=/bin/sh -c 'echo 95000000 > /sys/class/powercap/intel-rapl/intel-rapl:0/constraint_1_power_limit_uw'
RemainAfterExit=yes

[Install]
WantedBy=multi-user.target
A linha Before=pve-guests.service é crítica: garante que o limite é aplicado
antes de o Proxmox iniciar qualquer VM ou contentor com autostart. Se uma VM com
uma carga de trabalho pesada arrancar antes de o limite ser aplicado, o CPU pode
disparar sem restrição durante vários segundos.
Verificar após ativar:
sudo systemctl enable --now cpu-powerlimit.service
cat /sys/class/powercap/intel-rapl/intel-rapl:0/constraint_0_power_limit_uw
# 75000000
cat /sys/class/powercap/intel-rapl/intel-rapl:0/constraint_1_power_limit_uw
# 95000000
Uma ressalva: o BIOS da HPE pode sobrepor-se ao RAPL em alguns modelos ProLiant. Se os valores retornados forem diferentes dos que escreveu, o BIOS está a interferir. No Gen10 Plus com o firmware que estou a usar, as escritas RAPL têm efeito e persistem corretamente.
Limitar a GPU
A NVIDIA RTX A1000 suporta um limite de potência por software via nvidia-smi. O
limite de origem é 50 W; defini-o para 35 W. A A1000 é uma placa de workstation
concebida para cargas de trabalho profissionais contínuas; 35 W está bem dentro do
seu intervalo de operação.
sudo nvidia-smi -pl 35
Para persistir entre reinicializações:
# /etc/systemd/system/nvidia-powerlimit.service
[Unit]
Description=Set NVIDIA GPU power limit
After=nvidia-persistenced.service

[Service]
Type=oneshot
ExecStart=/usr/bin/nvidia-smi -pl 35
RemainAfterExit=yes

[Install]
WantedBy=multi-user.target
Uma particularidade da RTX A1000: o nvidia-smi reporta power.draw = [N/A]. A
placa não expõe um sensor de consumo em tempo real. O limite de 35 W é imposto por
firmware independentemente da carga, pelo que não é possível observar o consumo
instantâneo, mas sabe-se que não pode exceder o limite.
O balanço de consumo
Com os dois limites aplicados:

A margem de 10 W é estreita. É a mesma margem com que a configuração anterior (E-2224 de origem + limite de 30 W na GPU) funcionou de forma estável durante meses. Estou confortável com isso, mas vale a pena monitorizar periodicamente os registos de eventos do iLO para verificar se há eventos no regulador P12V.
Validação
Com o hardware trocado e os limites aplicados, realizei um teste de carga antes de restaurar o autostart das VMs.
GPU: carga contínua de 300 s
O teste de carga da GPU correu durante 5 minutos sem erros:
| Métrica | Observado | Limiar | Resultado |
|---|---|---|---|
| Erros (execução completa) | 0 | 0 | ✅ |
| Débito | ~2460 Gflop/s em carga contínua | — | — |
| Limite de potência (driver) | 35,00 W, mantido | ≤ 35 W | ✅ |
| Temperatura da GPU | 81 °C de pico | < 85 °C | ✅ |
| Utilização da GPU | 100 % | — | — |
Térmicos
A temperatura da GPU subiu de 74 °C para 81 °C e estabilizou durante toda a
execução. A carcaça compacta do MicroServer encaminha o calor de escape da GPU
pela área do CPU, o que tem importância: o turbostat mostrou o pacote CPU a
84–85 °C sem qualquer carga no CPU — exclusivamente por absorção de calor da
GPU. Leituras dos sensores iLO no final do teste (temperatura ambiente de entrada
de 27 °C):
| Sensor | Leitura | Limiar de atenção |
|---|---|---|
| Pacote CPU (turbostat) | 84–85 °C | parar aos 95 °C |
| CPU (iLO, próximo de inativo) | 40 °C | — |
| DIMM | 38 °C | — |
| Chipset | 57 °C | — |
| VR P1 | 52 °C | — |
| LOM | 73 °C | — |
| BMC | 90 °C | 105 °C |
A temperatura elevada do pacote em estado inativo é esperada nesta carcaça e encontra-se dentro dos limites. Significa, no entanto, que quando o CPU estiver sob carga real, a temperatura do pacote subirá ainda mais — e é exatamente por isso que o limite RAPL é importante.
Registo do kernel: sem falhas
sudo dmesg | grep -iE "regulator|throttl|thermal|power"
Sem eventos P12V, sem eventos de throttling. A única linha de interesse foi um registo normal do medidor de potência ACPI da HPE no arranque:
power_meter ACPI000D:00: Ignoring unsafe software power cap!
Esta mensagem não tem relação com o RAPL. O RAPL é aplicado através da interface
powercap do kernel de forma independente, e o turbostat confirmou CoreThr = 0
em todos os núcleos durante toda a execução.
Teste de carga do CPU
O teste combinado correu stress-ng --cpu 12 em paralelo com o gpu-burn, colocando
todos os 12 threads e a GPU sob carga simultânea. O sistema manteve-se estável
durante toda a execução. O limite RAPL foi exercitado sob carga real e manteve-se
nos valores configurados. Os dados detalhados do turbostat por núcleo não foram
registados nesta execução.
O que isto permite na prática
A GPU é passada em passthrough do host Proxmox para uma VM Linux dedicada que funciona como host Docker interno. Essa VM corre 33 containers entre serviços de infraestrutura e automação. Dos 33 containers, exatamente dois usam a GPU:
Worker de ML do Immich (MACHINE_LEARNING_DEVICE=cuda): trata dos embeddings
semânticos CLIP, do reconhecimento facial, e da deteção de objetos para a biblioteca
de fotografias. A indexação inicial de ~15.000 fotografias concluiu em menos de 10
minutos. Uma execução apenas com CPU na mesma biblioteca demora cerca de uma hora.
Servidor de embeddings TEI (stack Book RAG, porta 8090): corre o modelo BGE-M3 para gerar vetores de 1024 dimensões para o sistema de pesquisa da biblioteca pessoal de livros. Um livro de 400 páginas que demorava 3–4 minutos a processar no CPU é processado em menos de 20 segundos na GPU. A diferença acumula-se quando se ingerem vários livros na mesma sessão.
Os restantes 31 containers, desde o reverse proxy até ao broker MQTT, correm inteiramente no CPU. A GPU é um acelerador específico para as duas cargas de trabalho de ML, não um recurso de uso geral para a VM.
A contrapartida
A RTX A1000 não é barata para o que faz. É uma placa de workstation profissional com preço orientado para cargas de trabalho de CAD/3D, não para jogos de consumo. Escolhi-a porque funciona a baixo consumo (35 W com limite aplicado, sem conector de alimentação auxiliar necessário), cabe numa ranhura de meia altura, e suporta a stack de drivers profissionais da NVIDIA sem as restrições de nível de consumo que afetam o passthrough nas placas GeForce.
Se o objetivo for exclusivamente o Immich, uma GeForce GTX 1650 ou RTX 3050 usadas fariam o trabalho por muito menos. A A1000 fez sentido para a minha combinação de cargas de trabalho e para o caso de uso do passthrough.
A lição mais abrangente é que a fonte de 180 W não é o obstáculo que parece. Entre o Intel RAPL e os limites de potência do nvidia-smi, tem-se um controlo razoavelmente preciso sobre o envelope de consumo. Basta fazer as contas antes de começar, limitar os dois componentes, e verificar que os limites estão efetivamente aplicados antes de a primeira carga de trabalho real arrancar.